k0s 跑 GPU 实录:四步让 Pod 用上 Tesla T4
场景很简单:内网一台服务器,256G 内存,插一张 Tesla T4,装的 k0s,要部署一个模型推理服务,算力全在 GPU 上。
麻烦在于 Kubernetes 不认识显卡。CPU、内存天生是可调度资源,GPU 不是,从硬件到 Pod 真正拿到卡,中间隔着四层组件:宿主机驱动、NVIDIA Container Toolkit、RuntimeClass、Device Plugin。少装任何一层,现象各有不同,结论只有一个:卡用不上。
代码全部来自实际环境:CentOS 7、k0s 单机、T4 一张,踩到的坑一并附上。
先看全局:四层各管一件事
1 | |
| 组件 | 位置 | 职责 | 本文版本 |
|---|---|---|---|
| NVIDIA Driver | 宿主机 | 驱动硬件,提供 nvidia-smi | 550.163.01 |
| nvidia-container-toolkit | 宿主机 | 让容器看得见 GPU | 1.14.6-1 |
| RuntimeClass | K8s API 对象 | 给运行时起名,供 Pod 选择 | handler: nvidia |
| nvidia-device-plugin | DaemonSet | 把 GPU 报给调度器 | v0.14.5 |
环境交代:CentOS 7,k0s 单机(controller 和 worker 同节点),内网不出网。驱动用 local repo 的 rpm 包,镜像全部先进内部 registry。
第一步:宿主机装驱动
驱动从 NVIDIA 官网下载对应卡型的 local repo 版 rpm,一个包自带完整 yum 仓库,安装时不依赖外网,正适合内网机器:
1 | |
重启后第一件事:
1 | |
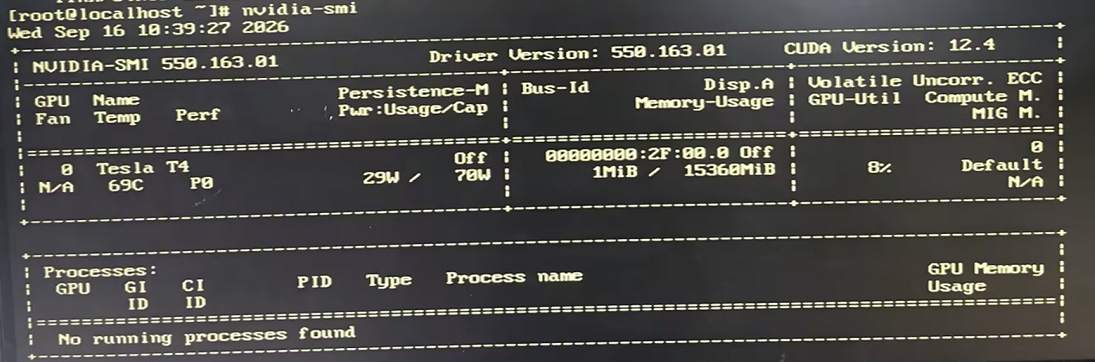
T4 认出来了:驱动 550.163.01,CUDA 12.4,显存 15360MiB
到这一步只解决了硬件层。驱动让操作系统看见了卡,容器那一层它管不着,后面三步都是为容器服务的。
第二步:Toolkit,让容器看得见显卡
容器里要用 GPU,得有人把驱动库和设备文件挂进容器,这件事归 nvidia-container-toolkit 管。
CentOS 7 的包从 libnvidia-container 仓库的 gh-pages 分支拿,NVIDIA 把 rpm 直接放在 GitHub Pages 上:stable/rpm/x86_64。
1 | |
版本是第一个坑:toolkit 必须大于等于 1.14,nvidia-ctk 的 runtime configure 子命令才有 containerd 可选,老版本只认 docker。
第二个坑是 k0s 特有的。k0s 用内置 containerd,不读 /etc/containerd/config.toml,自定义配置统一放进 drop-in 目录 /etc/k0s/containerd.d/。nvidia-ctk 生成配置时加 –dry-run,输出正好重定向进 drop-in:
1 | |
重启 k0scontroller,内置 containerd 带着新配置一起起来。
新一点的系统用 dnf,包名不变,版本到 1.20.0-1,步骤相同,参考官方安装指南:
1 | |
第三步:RuntimeClass,给 nvidia 运行时上户口
containerd 里现在有两组运行时:默认的 runc,和新配置进去的 nvidia。K8s 的 Pod 想点名用 nvidia,需要先有一个 RuntimeClass 对象:
1 | |
metadata.name 随意起,handler 必须和 containerd 配置里的运行时名对上。
如果把 nvidia 配成了节点默认运行时,这一步可以省掉。我的场景是多运行时混跑,nvidia 只是装进来了、没动默认值,所以 Pod 必须按名选择,这正是官方文档里 runtimeClassName 参数的典型用法。
第四步:Device Plugin,把卡报给调度器
前三步做完,节点已经能跑带 GPU 的容器,但调度器还不知道这台机器有卡。device-plugin 的活儿是把 GPU 以 nvidia.com/gpu 的名义上报给 kubelet。
官方 YAML 改两处就能用(对应下面两处「对比官方」注释):
1 | |
两处改动的含义:
第一处,runtimeClassName: nvidia。插件 Pod 自己也要走 nvidia 运行时,它的工作就是探测驱动、枚举设备,本身就是一个需要看见 GPU 的容器。上一节的 RuntimeClass 在这里派上用场。
第二处,–container-driver-root=/。告诉插件驱动在容器内的根路径在哪。驱动是宿主机直装的,nvidia 运行时把驱动挂进容器根路径,所以写 /。换成 GPU Operator 那种 driver container 方式,驱动挂在 /run/nvidia/driver 之类的路径,这个值就得跟着改。
另外两个细节:镜像走内部 registry,拉不了的先从 nvcr.io 导入官方镜像;FAIL_ON_INIT_ERROR 设为 false,DaemonSet 会铺满集群所有节点,没装卡的节点上让插件安静退出,而不是起失败。
最后一步:Workload 把卡要过来
调度器认识卡了,剩下的就是在工作负载里声明。项目用 KubeVela 管应用,完整的 Application 长这样:
1 | |
GPU 相关的字段全在 json-patch 里。webservice 组件不直接认识 runtimeClassName,用 patch 往 Pod template 加两个字段,一个选 nvidia 运行时,一个声明 GPU 资源。裸 Pod 的等价写法,就是在 spec.containers[].resources 里加 nvidia.com/gpu: “1”。
scaler 那行注释是大实话:副本要一整张卡,一张 T4 只够调度一个副本。想一卡多副本,整卡分配这条路走不通,得做 GPU 虚拟化,推荐 HAMi:把物理卡切成多份 vGPU,显存按 MB 限额,算力也能封顶,CNCF 沙箱项目,NVIDIA 卡之外昇腾、寒武纪这些卡也在支持范围。业务侧的改动很小,资源声明从整卡换成切片就行,比如一张卡切三份:
1 | |
声明之后调度器按 vGPU 分配,副本数就能超过卡数。
旁路:单机场景 Docker 一把梭
同一个服务也留了纯 Docker 版本,k0s 没铺开之前或者临时给算法起个实例,一条命令:
1 | |
–gpus all 是新写法,背后依赖的还是第二步装的 toolkit。老版本 docker 走 daemon.json 配运行时:
1 | |
这个模型不大,实测一张 T4 能同时跑 4 个实例,四个容器共享 16G 显存。对比 K8s 的整卡分配就能看出差别:Docker 里四个容器挤一张卡没有约束,K8s 里 nvidia.com/gpu 是整数资源,1 就是 1。
实在赶时间,临时装个 docker 用老方法把算法跑起来,也是条退路。
踩坑清单
- k0s 的 containerd 是内置的。改 /etc/containerd/config.toml 没有任何用,配置写进 /etc/k0s/containerd.d/,然后重启 k0scontroller。
- toolkit 版本要 ≥ 1.14,低版本的 nvidia-ctk 没有 containerd 运行时可配(见 issue #1404)。
- nvidia 不是默认运行时时,要指名的位置有三处:RuntimeClass 对象、device-plugin 的 Pod、业务 Pod。漏任何一处,现象都是 Pod 卡在 ContainerCreating。
- T4 默认整卡分配,一卡一副本。想一卡跑多副本,上 HAMi 做 GPU 虚拟化,把卡切成 vGPU 按需分配。
- 设备插件和 GPU Operator 是两条路线。手装四件套依赖少,每一步可见;GPU Operator 把驱动、toolkit、插件全托管成集群组件,节点多的集群值得上,单机没必要。同款路线的实战参考,有人在 k0s 上跑了 llama.cpp:Running llama.cpp on k0s。